考点不是全部
考前复习清单:只列要懂的机制与参数,不写语法。每一节先讲原理,再给考点与代价;不用回头翻 PPT。
不考
- 程序语法、Scala / Spark 的写法
- HDFS 指令
- 并行计算的历史
- hybrid 之后的延伸(停在 hybrid 就好)
要会
- 为什么要这样做、什么时候不成立
- 换到什么代价(bytes、扫描次数、内存)
- 画得出流程:区块 → 洗牌 → 阶段 → 树
- 宽图在手机上不用左右滑,竖排版直接读
数据与系统
chap1 · p.10–72
原理 大数据指三个假设同时失效:机器会坏、数据没有统一 schema、查询不一定跑得完。RDBMS 用强 schema 与单机扩展换正确性;当数据到 PB、节点到千级,这笔交换就不划算了。四个 V 里,Volume 只是入口:Variety 让 schema 失效,Velocity 让批处理来不及,Veracity 让结果本身可疑。
- 并行 RDBMS 为什么撑不住? 它保证 ACID、要求 schema,扩展靠很贵的机器;节点一多(讲义的例子:超过 100),查询可能跑不完。这就是 big data 要换架构的起点。正文的比较表。
- 结构分三种。 Structured(表格)、semi-structured(JSON/XML, schema 混在数据里)、unstructured(轨迹、影像、文字)。Veracity 是可信度,与 Volume、Variety、Velocity 并列,不是数据结构。
- 五个挑战。 储存成长、感测器撷取、即时处理、分布式 mining、来源与结果的品质评估。
- Value 的路径。 收集 → 处理 → 知识; descriptive(描述:聚类、关联)vs predictive(预测:分类、推荐)。
- 数据集类型。 关联式表格(DBMS)、图、有序数据(交易、序列、时序、空间)、高维数据、有标签的数据;不同类型配不同方法:聚类、关联规则、分类、异常检测。
- 描述性方法。 描述性方法回答「长什么样」:摘要统计、聚类、关联规则;预测性回答「接下来会怎样」:分类、回归、推荐。这一页的 Apriori 与子空间聚类都属于描述性。
- Google Flu 的教训。 97% 相关也会高估;大数据是补充,不是替代。
DFS 与 MapReduce
chap2 · p.73–140
原理 一台机器装不下,就把文件切块撒到很多机器;机器会坏,就每块存三份;要算,就把程序搬到数据旁边。MapReduce 把「怎么并行」藏起来:你只写 map 与 reduce,分区、洗牌、排序、重试都由框架做。代价是 map 与 reduce 之间一定有一次跨网络洗牌。
- DFS 三个好处。 数据分割 + 副本 → scalability、fault tolerance、high concurrency。分布式计算的三个难题:scalability、fault tolerance、recoverability。
- Commodity cluster。 便宜、标准化、可替换的硬体;机架 + 两层网络;数据并行;坏掉是常态(1000 台 ≈ 每天一台)。
- 为什么一定要并行。 Peta-scale 常见、1000+ 节点常见、failure 例行、massive parallelization 是必须。
- MapReduce 的两条规则。 同一个键 → 同一个 reducer;每个 reducer 里的键是排好序的。partitioning、shuffle、sort、join 全是这两条的女儿。
- 比较架构。 schema(要/不要)、表达方式(SQL 宣告式/程序语言)、排程(编译期/执行期)、数据流(push/pull)、粒度(查询级/区块级)。
- Hybrid 到这里就好。 HadoopDB(系统层把单机 DB 放进 Hadoop)、Aster/Greenplum(在 RDBMS 里写 MapReduce)、Hive/Pig(把 SQL 叠回 MapReduce)。再往后不考。
HDFS
chap3 · p.141–162
原理 大文件 + 会坏的机器 = 大块 + 多副本 + 一个只记位置的目录。块大,NameNode 的 metadata 才装得下;副本跨机架,坏一个机架才不丢数据;写管线把 packet 沿 DataNode 链传,ack 回来才算写完。HDFS 为「一次写、多次读」的大文件设计,不是小文件或频繁修改。
- 区块。 128MB(不是 Linux 的 4KB),默认三份。为什么大:seek 时间摊在大量传输上、NameNode 的内存只记区块、文件本来就很大。
- 架构。 NameNode 记 metadata 与区块位置、管权限、收 heartbeat;DataNode 真的存、读写、复制、回报。
- 副本放在哪。 第一份在写入端,第二份跨机架,第三份回到第二个机架的另一台。所以拔一台、拔一个机架,数据都还在。
- 读与写。 读:问 NameNode 拿位置清单,挑最近的 DataNode。写:切成 packet,建 pipeline,沿著 DataNode 串流。
- Hadoop 原则。 scale-out、software fault tolerance、data locality(把程序搬到数据旁边)。指令不考。
Spark
chap4a–b · p.163–296
原理 MapReduce 每次落盘,Spark 把中间结果留在内存;RDD 不可变,坏了可以按 lineage 重算;narrow dependency 可以 pipeline 进同一个 stage,wide dependency 才洗牌。快不是魔法,是把 I/O 与重算的代价换成内存。
- Pair RDD。 每一列是 (key, value)。常用:mapValues、groupByKey、reduceByKey、sortByKey、join。
- Transformation vs action。 Transformation 是 lazy,回一个新 RDD(map、flatMap、filter、reduceByKey);action 才会真的算(collect、count、take、reduce)。没有 action,整条链什么都不做。
- 函数的能力边界。 map 一对一、flatMap 一对零到多、filter 留或不留、reduce 需要结合律与交换律、reduceByKey 先把同键的值并起来。
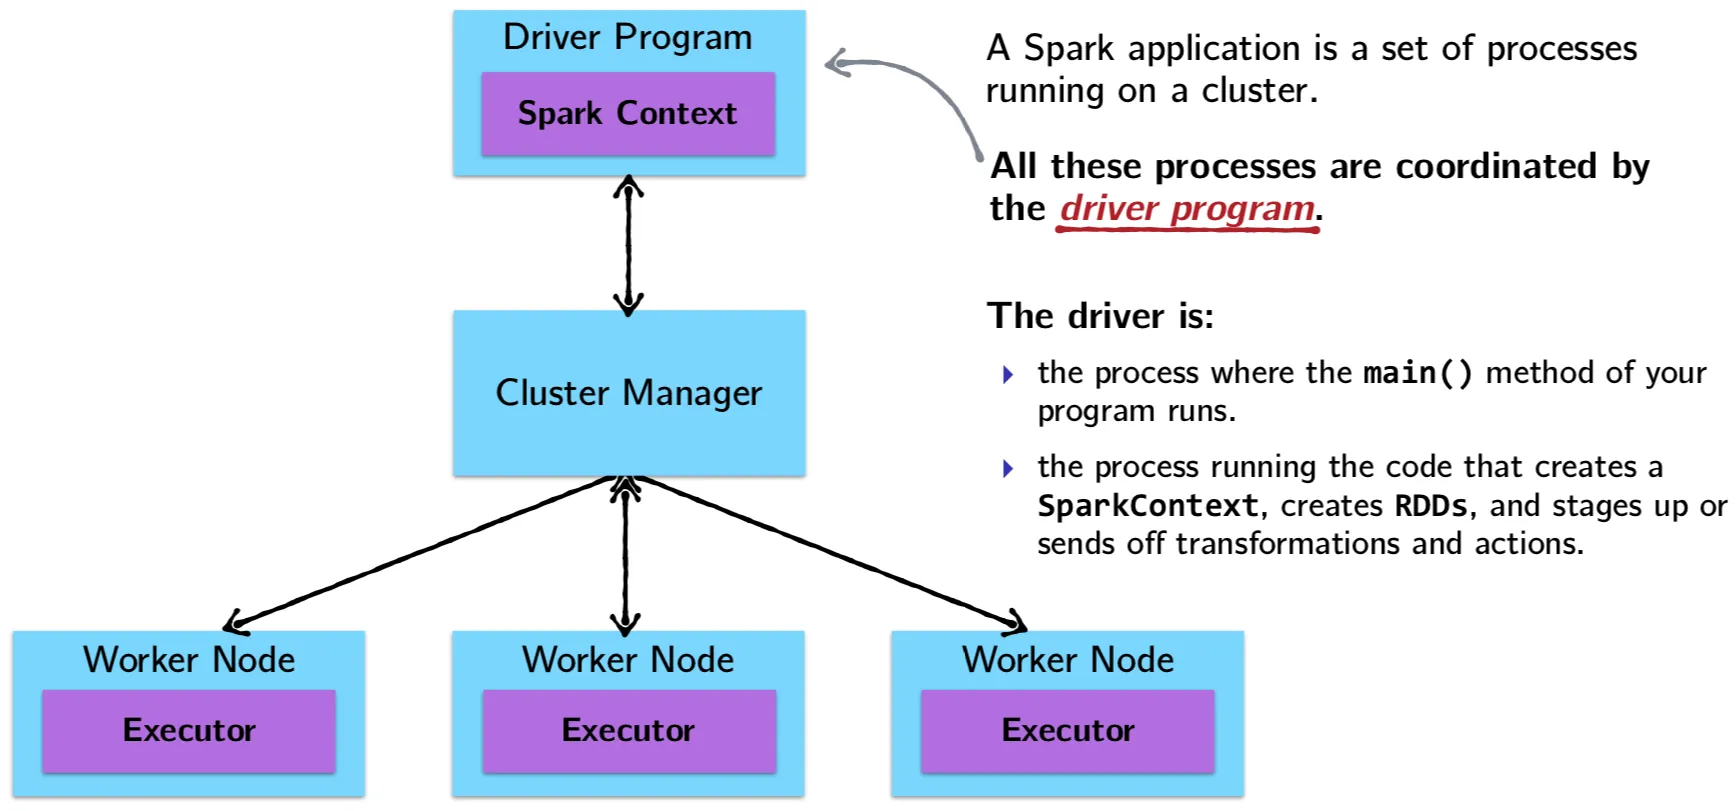
- Job 怎么跑。 spark-submit 起 driver;driver 向 cluster manager 要资源,起 executor;driver 读 lineage 决定 task 数;一个 action = 一个 job;wide dependency 切成 stage;task 落到 executor。
- 快在哪。 中间结果留在内存、narrow dependency 可以 pipeline、lineage 让重算只补坏掉的那一份。
两层要分清
DFS 与 RDD,别混在一起
存储层 / 计算层
DFS 是「数据放在哪」,RDD 是「怎么算」。
原理 两个都叫「分布式」,但一个在存储层、一个在计算层;分不清这两层,后面的题都会答反。
- DFS(储存层)。 文件切成 128MB 区块、三份副本、NameNode 记位置、DataNode 存数据;好处是 scalability、fault tolerance、high concurrency。
- RDD(计算层)。 不可变、分区、记 lineage;transformation 只描述新 RDD,action 才触发计算。
- 核心差别。 transformation 是 lazy,回一个新 RDD;action 是 eager,回一个值或把结果写出去。没有 action,整条链不执行。DFS 管「把区块放好」,RDD 管「在区块上算」。
频繁项集与子空间
chap5a–b、chap6a · p.297–509
原理 找所有频繁项集是 NP-hard,所以每个算法都在换:换扫描次数、换内存、换一点正确性。Apriori 用单调性剪枝;FP-tree 用一棵树换掉反复扫描;子空间聚类把「距离」换成「密度」,在低维投影里找密集格子。
- Apriori。 支持度 = 出现几次;置信度 = 出现后真的会买的比率。单调性:子集大,超集才可能大。join → prune → count,一层一层。
- {B,C}→E 的陷阱。 置信度 66.7% 没错,但支持度只有 2,在门槛 3 之下连候选都不是。
- 放不进内存。 PCY(哈希桶先滤)、SON(切块各跑再并集)、Toivonen(负边界,赌输重来)。
- FP-tree。 扫一次、排序、建树、条件模式基底;用一棵树换掉反复扫描。
- 子空间。 密集单位(CLIQUE)、熵 H(X) < ω、KL 转换把轴转到方差方向;最小特征值那条常常就是子空间。
自测 12 题
12 题
先遮住答案自己答一遍,再往下对。每一题都能在正文或讲义里找到出处。
1. 1 TB 的文件,切成 128MB 的区块,共几个?三份副本共几份?
1 TB = 1,099,511,627,776 bytes ÷ 134,217,728 = 8,192 个区块;× 3 = 24,576 份副本。
2. 为什么 HDFS 的区块是 128MB,不是 4KB?
减少区块数量 → NameNode 的 metadata 不会爆;seek 时间摊在大量连续传输上;HDFS 本来就为大文件设计。
3. 拔掉一整个机架,数据为什么还读得到?
每块有三份,最多只有两份会被放在第二个机架;第一个机架还有一份。这是把第二份放到别的机架的理由。
4. 为什么同一个键一定要去同一个 reducer?
reduce 要看到一个键的全部值才能合并;分散到不同 reducer 就无法得出完整的结果。
5. MapReduce 的 sort 与 join 靠哪个副作用?
shuffle 之后,每个 reducer 收到的键是排好序的。sort 用 range partitioner;join 把两边打上 LEFT/RIGHT 标签送进同一个 reducer。
6. 并行 RDBMS 与 MapReduce,在 schema 与排程上的差别?
RDBMS 要求 schema、编译期排程、有优化器;MapReduce 不要 schema、执行期排程、没有全域优化。
7. transformation 与 action 差在哪?没有 action 会怎样?
transformation 是 lazy,只回一个新 RDD;action 才触发计算。没有 action,Spark 什么都不做。
8. narrow 与 wide dependency 对 stage 的影响?
narrow 可以 pipeline 进同一个 stage;wide 需要洗牌,是 stage 的边界。
9. 支持度 3 之下,{B,C}→E 为什么不是答案?
它的支持度只有 2(< 3),不是频繁项集;置信度再高也过不了第一关。
10. 为什么两维看不到集群,只看 Age 反而有?
密度是相对格子算的:每个 2D 格子最多 2/48 = 4.2%,但 A3 这个年龄带有 12/48 = 25%,所以在子空间里才过门槛。
11. 熵 3 bit 与 0 bit 分别代表什么?
3 bit:八匹马等概率,最不确定;0 bit:结果已定,没有信息量。熵是平均描述长度,越小越「有结构」。
12. KL 转换为什么保留最小特征值的方向?
最小特征值 = 方差最小的方向;投影到那里,点会挤在一起,子空间的集群才浮出来。投到最大特征值的方向则是最小信息损失的降维。
术语与参数
中文 / English
每一个词都给一句话解释,重要参数附上讲义里的值。不写语法,只写「它是什么、什么时候用、代价是什么」。
存储与集群 · DFS / HDFS
- 分布式文件系统 DFS
- 文件切成块、分散在多台机器;换来 scalability、fault tolerance、high concurrency。
- 区块 block
- 切块单位,默认 128MB(134,217,728 bytes);Linux 的块是 4KB。块大是为了少记 metadata、把 seek 摊薄。
- 副本 replica
- 每块默认 3 份;第一份本机架、第二份跨机架、第三份回到第二机架的另一台。
- 名称节点 NameNode
- 记文件名、目录、块到 DataNode 的映射;收 heartbeat。它不存数据本身。
- 数据节点 DataNode
- 真的存块、读写、复制、向 NameNode 汇报。
- 机架 rack
- 一组节点共用交换机;副本跨机架,拔一个机架才不丢数据。
- 商品化集群 commodity cluster
- 便宜、标准、可替换的硬件;机器会坏是设计前提(1000 台 ≈ 每天一台)。
- 写入管线 write pipeline
- 客户端把块切成 packet,沿 DataNode 链写,ack 沿原路回来。
- 读取 read
- 先向 NameNode 要块位置,再挑最近、最不忙的副本。
MapReduce
- 映射 map
- 逐条把 (k1, v1) 变成一批 (k2, v2)。
- 分区器 partitioner
- hash(key) mod R,决定键去哪个 reducer;R 是 reducer 数。
- 洗牌 shuffle
- 按 reducer 分区、排序、跨网络搬运;整个 job 最贵的一步。
- 归约器 reducer
- 收到一个键的全部值,合并成结果。
- 合并器 combiner
- map 端先局部合并,减少洗牌量;要满足结合律与交换律。
- 两条规则
- 同键同 reducer;每个 reducer 内的键有序。sort 与 join 都靠这个副作用。
- 连接 join
- 把两边打上 LEFT / RIGHT 标签,送进同一个 reducer 按键对齐。
Spark
- 弹性分布式数据集 RDD
- 不可变、分区、记 lineage;坏掉的 partition 可以重算。
- 键值对 RDD pair RDD
- 每行是 (key, value);只有它才有 reduceByKey、groupByKey、join。
- 转换 transformation
- 惰性,回一个新 RDD:map(一对一)、flatMap(一对零到多)、filter(留/不留)、distinct、union、intersection、subtract、sample、mapValues、groupByKey、reduceByKey、sortByKey、join、cogroup。
- 动作 action
- 触发计算,回一个值或写出去:collect、count、take、reduce、foreach、saveAsTextFile。
- 核心差别
- transformation 只描述血缘;action 才真的算。没有 action,整条链什么都不做。
- 窄依赖 narrow dependency
- 一个父分区只喂一个子分区(map、filter);可以 pipeline 进同一个 stage。
- 宽依赖 wide dependency
- 多个子分区要同一个父分区(reduceByKey、groupByKey、join 的 shuffle);是 stage 的边界。
- 有向无环图 DAG
- lineage 按 wide 依赖切成 stage,每个 stage 按 partition 切成 task。
- 驱动 / 集群管理器 / 执行器 driver / cluster manager / executor
- driver 排程;cluster manager 给资源;executor 跑 task、缓存数据。
- 谱系 lineage
- 每个 RDD 记得怎么从父 RDD 算出来;丢分区只重算那一份。
- 缓存 cache / persist
- 把中间结果留在内存;这是「快一百倍」的来源。
- 分区器 partitioner
- hash 或 range,决定 key 落到哪个 partition;reduceByKey 默认 hash,sortByKey 用 range。
算法 · Apriori / FP-tree / 子空间
- 支持度 support
- 包含该项集的交易数或比例;门槛例 3(讲义的 5 笔交易)。
- 置信度 confidence
- support(X∪Y) / support(X);例 {B,C}→E 是 2/3 = 66.7%。
- 频繁项集 frequent itemset
- 支持度 ≥ 门槛的项集。
- 单调性 monotonicity
- 子集不频繁,超集一定不频繁;用来剪枝。
- 候选集 candidate set
- join 生成、prune 剪掉、count 计数的中间结果。
- 负边界 negative border
- 样本里刚好不频繁、但所有子集都频繁的最小项集。
- PCY / SON / Toivonen
- 哈希桶先筛配对 / 切块各跑再合并 / 采样加负边界,赌输重来。
- FP 树 FP-tree
- 扫一次、排序、建树;用条件模式基底代替反复扫描。
- 密集单元 dense unit
- 格子里点数超过门槛(例 20%);相连的密集单元才是簇。
- 熵 entropy
- 平均不确定性:八匹马等概率是 3 bit,确定是 0 bit;H(X) < ω 当聚类准则。
- KL 转换 KL transform
- 把坐标轴转到协方差矩阵的特征向量方向;λ 大 = 方差大,最小 λ 的方向常是子空间。
关键参数
| 参数 | 值 | 在哪里 |
|---|---|---|
| dfs.blocksize | 134,217,728 B(128 MiB) | HDFS |
| dfs.replication | 3 | HDFS |
| reducer 数 R | 由 job 设定(讲义例子 2) | MapReduce |
| 支持度门槛 | 3(例子) | Apriori |
| 置信度门槛 | 50%(例子) | 关联规则 |
| 密集单元门槛 T | 20% | CLIQUE |
| 熵门槛 ω | 由使用者定 | 熵聚类 |
| 特征值 λ | 4 与 1(例子) | KL 转换 |
真正要背的只有四个:区块 128MB、副本 3 份、支持度门槛 3、密集单位 20%。其余的值考试会给,或要你从题目推。